網站擁有人可否分開控制 AI 爬蟲的搜尋、訓練和用戶要求存取?
不少供應商會分開記錄自動搜尋爬取、可能用於模型訓練或 grounding 的內容,以及用戶觸發的檢索控制。控制效果因供應商而異:例如,OpenAI 分開說明 OAI-SearchBot、GPTBot 和 ChatGPT-User;Google 則表示 Google-Extended 控制指定的未來 Gemini 訓練和 grounding 用途,但不影響 Google 搜尋收錄或排名。robots.txt 提供爬蟲指示,並非存取授權。應分開核對相關供應商規則和實際頁面傳送情況;這些控制均不保證收錄、引用、從已訓練模型中刪除內容,或獲所有爬蟲遵守。
一次頁面造訪,不能回答所有存取問題
供應商可能為自動搜尋發現、可能用於模型開發的內容,以及由個人發起的檢索,使用不同爬蟲或產品 token。這些用途各有不同,不應把其中一項控制當作通用的 AI 存取開關。Google-Extended 有一項重要分別:Google 說明它用來控制未來 Gemini 模型訓練及指定的 grounding 用途,而不是控制 Google 搜尋收錄或排名。
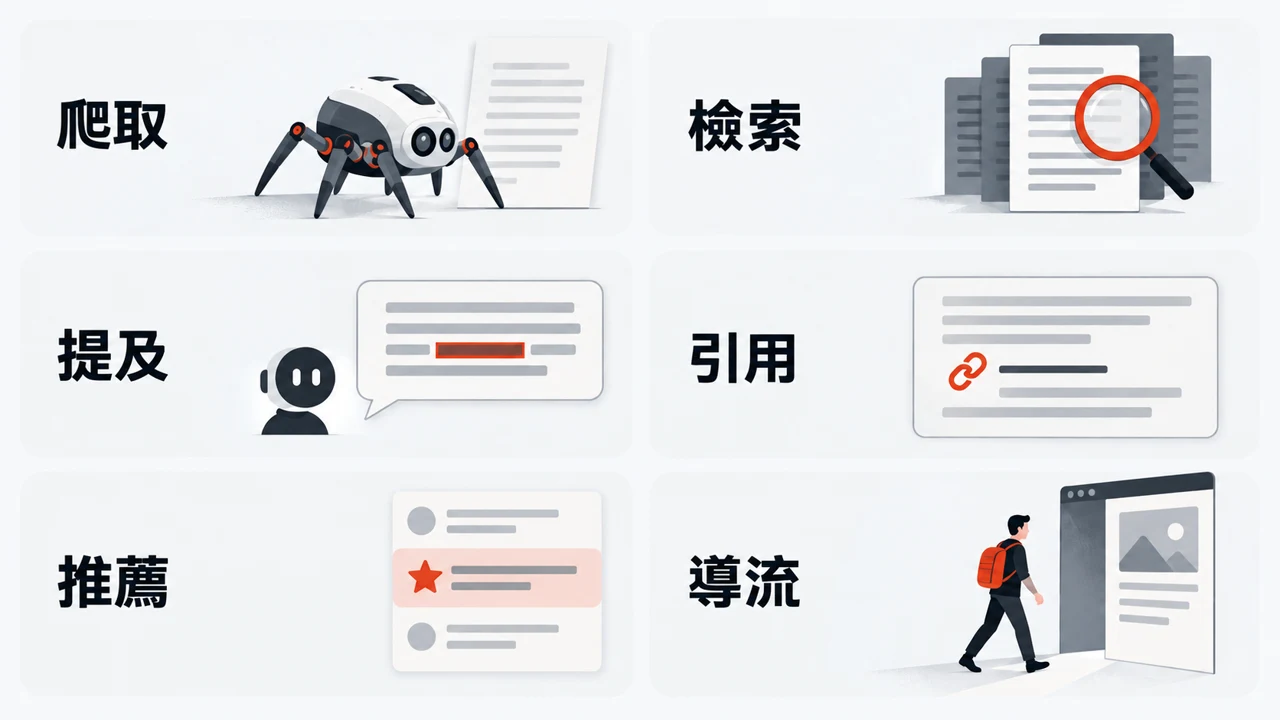
存取觀察與答案結果應分開處理。爬取、檢索、提及、引用、推薦和導流是不同的觀察;其中一項的證據不能證明另一項,而插圖亦不是有保證的流程。
資料來源: Overview of OpenAI Crawlers; Does Anthropic crawl data from the web, and how can site owners block the crawler?; List of Google common crawlers; AI features and your website
供應商控制及其已說明的界限
下表概括各項控制所述的用途,並非適用於所有爬蟲或網站的通用規則。HTTP 要求中的 user-agent 字串,不一定等同 robots.txt 群組所用的產品 token。Google-Extended 有 robots.txt 控制 token,但沒有獨立的 HTTP 要求 user-agent。應按相關主機和用途核對供應商文件;各項已記錄的選擇及例外不能互換。
已記錄的控制及重要限制
橫向捲動以閱讀所有欄位。
| 供應商控制 | 已說明的用途 | 重要界限 |
|---|---|---|
| OpenAI OAI-SearchBot | 供 ChatGPT 搜尋功能自動發現網站內容。 | OpenAI 表示,拒絕 OAI-SearchBot 的網站不會出現在 ChatGPT 搜尋答案中,但仍可能以導覽連結形式出現。 |
| OpenAI GPTBot | 爬取可能用於訓練 OpenAI 基礎模型的內容。 | OpenAI 說明 GPTBot 與 OAI-SearchBot 相互獨立。禁止 GPTBot 表示內容不應用於這項訓練用途;但不能據此確定內容已從已訓練模型中移除。 |
| OpenAI ChatGPT-User | 因 ChatGPT 或 Custom GPT 用戶操作而發生的部分造訪;並非自動網絡爬取。 | OpenAI 表示,robots.txt 規則可能不適用於這些由用戶發起的要求。此控制不管理搜尋退出設定;OAI-SearchBot 才是已說明的搜尋控制。 |
| Anthropic Claude-SearchBot | 改善用戶搜尋的結果質素及索引。 | Anthropic 表示,停用它會阻止為搜尋優化而索引內容,並可能降低網站在用戶搜尋結果中的可見度或準確度。 |
| Anthropic ClaudeBot | 收集可能用於模型訓練的網頁內容。 | Anthropic 表示,限制存取代表未來資料應排除於其 AI 模型訓練資料集之外;這並非對已訓練模型的聲明。 |
| Anthropic Claude-User | 因應用戶查詢而擷取網頁內容。 | Anthropic 表示,停用它會阻止這類檢索,並可能降低網站在用戶主導網絡搜尋中的可見度。Anthropic 說明其爬蟲會遵守 robots.txt 指示。 |
| Google Googlebot | Google 搜尋爬取,包括 AI Overviews 和 AI Mode。 | Google 指明 Googlebot 是搜尋存取控制。若把它當作只控制訓練,亦會影響搜尋爬取;允許爬取本身不保證頁面會出現在搜尋結果。 |
| Google Google-Extended | 控制已爬取內容能否用於未來 Gemini 模型訓練,以及 Gemini Apps 和 Vertex AI 的 Grounding with Google Search 中指定的 grounding 用途。 | 它不影響 Google 搜尋收錄或排名,亦沒有獨立的 HTTP 要求 user-agent。Google 說明此 token 控制未來用途,並非把內容從已訓練模型中移除。 |
資料來源: Overview of OpenAI Crawlers; Does Anthropic crawl data from the web, and how can site owners block the crawler?; List of Google common crawlers; AI features and your website
robots.txt 是爬蟲指示,不是門鎖
Robots Exclusion Protocol 要求自動爬蟲遵守關於路徑存取的規則。RFC 9309 明確指出,這些規則並非存取授權。robots.txt 檔案可供公眾讀取;列出敏感路徑可能令路徑更容易被發現,而不是令其保密。若內容需要限制存取,應使用身份驗證等應用程式層級的存取控制。
應分開檢查政策文字、身份驗證和實際傳送情況。即使 robots 規則允許存取,主機或 CDN 設定仍可能阻止爬蟲讀取頁面;robots 指示本身亦不會阻止要求發出。供應商文件會說明特定的遵守方式,但不應把指示視為所有用戶端都會遵守的保證。要求中的爬蟲名稱本身,不能證明其身份。
資料來源: RFC 9309: Robots Exclusion Protocol; List of Google common crawlers; Overview of OpenAI Crawlers; Does Anthropic crawl data from the web, and how can site owners block the crawler?
修改設定前的檢查流程
按以下次序釐清擬議修改的用途。此流程不會更改網站設定,也不能判定頁面會否出現在搜尋結果或答案中。
列明內容和用途
指出具體的公開頁面,以及目標涉及搜尋發現、可能的訓練用途、grounding,還是用戶要求的檢索。不要把「AI 存取」視為單一用途。
核對相應的供應商規則
閱讀供應商文件,以及相關主機的 robots.txt 群組。先檢視現有規則,不要照抄全面封鎖指示;並核對已說明的控制是 HTTP user-agent 還是 robots 產品 token。
分開檢查實際傳送和保護措施
檢查相關頁面和 robots.txt 是否實際可供讀取,包括主機或 CDN 的限制。私人或僅供帳戶使用的資料應以適當存取控制保護;robots 規則不能代替這些措施。
記錄實際觀察,不要記錄推測
記錄已檢視的規則和實際觀察到的存取結果。曾被擷取不代表已收錄於搜尋結果或獲得引用。訓練退出訊號不代表內容已從已訓練模型中刪除;一間供應商所述的遵守方式亦不代表普遍適用。
資料來源: RFC 9309: Robots Exclusion Protocol; AI features and your website; Overview of OpenAI Crawlers; Does Anthropic crawl data from the web, and how can site owners block the crawler?
資料來源
- Overview of OpenAI CrawlersOpenAI · 查閱日期 探索引用此來源的內容
- Does Anthropic crawl data from the web, and how can site owners block the crawler?Anthropic · 查閱日期 探索引用此來源的內容
- List of Google common crawlersGoogle for Developers · 查閱日期 探索引用此來源的內容
- AI features and your websiteGoogle Search Central · 查閱日期 探索引用此來源的內容
- RFC 9309: Robots Exclusion ProtocolIETF · 查閱日期 探索引用此來源的內容
延伸閱讀
按用途檢查控制,不要只看「AI」一詞
先列明公開內容,以及具體的搜尋、訓練或 grounding 用途,再核對供應商現行文件和適用的主機規則。把 robots 指示與身份驗證、實際頁面傳送分開處理。爬取紀錄只能證明曾有造訪,不代表已收錄或獲得引用。
檢查我的品牌